


 会员登录

中国大模型的斩杀线 被斩杀了
文|Sleepy
10 月 8 日,Anthropic 发布 Haiku 5.5。对于不超过 10 万 token 的短请求,每百万 token 输入收 0.1 美元、输出收 0.5 美元,只有上一代 Haiku 4.5 的十分之一。
当天上午,Dragonfly 管理合伙人 Haseeb Qureshi 在 X 上贴出两张 Artificial Analysis 的散点图,配了一句:
「If you want the cheapest LLMs, you should now buy American.」
(想要最便宜的大模型,现在该买美国货了。)
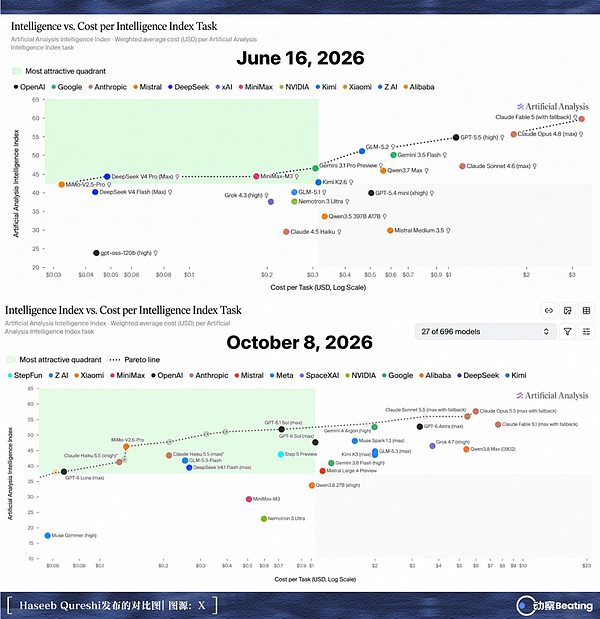
散点图的横轴是完成一次基准任务要花的钱,纵轴是得分。连接所有最优解的那条虚线,在微观经济学里叫帕累托前沿,线上每一个点都意味着,在同等成本下你找不到更聪明的模型。
6 月那张图上,虚线最便宜的那一端,是小米 MiMo、DeepSeek V4 Pro、MiniMax-M3 和智谱 GLM-5.2,几乎全是中国大模型的名字。
到了 10 月 8 日,整条线被 Anthropic 和 OpenAI 接管。中国模型只剩下一个 MiMo 还勉强挂在边缘,智谱 GLM-5.3-Flash 和 DeepSeek V4.1 Flash 则被一掌推到了 Haiku 5.5 的右下方,意味着相比之下它们花得更多,得分更低。
当天港股开盘,大模型概念股应声下挫。上午 10 点 26 分,MiniMax 跌幅扩大至 10%,智谱跌 5.6%。午盘恒生科技指数跌 1.93%,两家大模型新贵跑输大盘近五倍。
过去两年,中国开源与高性价比模型,给全球大模型市场焊死了一条斩杀线。只要把价格压进泥地,海外走量档的闭源模型就难以为继。硅谷明星公司排着队把底层管道换成中国开源大模型。
如今,牌桌被掀了。
斩杀线,被斩杀了。
斩杀线的形成
2023 年 3 月 GPT-4 刚上线时,8K 上下文版本的官方报价是每百万输入 30 美元、输出 60 美元。
智能极度稀缺,供给由极少数硅谷寡头垄断,价格完全是卖方市场。那是一个相信「智力可以单独溢价」的蜜月期。
打破这一神话的,是一家由中国量化对冲基金孵化的技术团队。2024 年 5 月 6 日,DeepSeek 推出 V2。2360 亿总参数,每个 token 仅激活 210 亿;依靠 MLA 架构与极致的工程剪裁,团队将 KV cache 砍掉了 93.3%,吞吐量拉升至 5.76 倍。省下来的算力直接折现为商业定价,每百万输入 1 元人民币,输出 2 元。
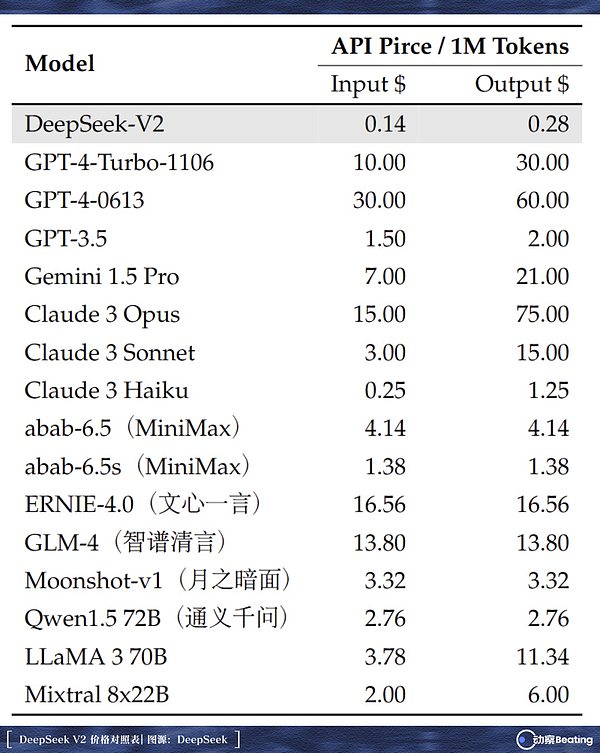
国内大厂几乎是被生拉硬拽拖进价格战的。
5 月 15 日,字节跳动火山引擎发布豆包,主力模型给出 0.0008 元/千 token 的企业价,宣称比行业均价便宜 99.3%。5 月 21 日,阿里云宣布通义千问系列断崖式降价,Qwen-Long 输入端折合每百万 token 仅收 0.5 元;数小时后,百度文心两款主力模型直接宣布免费。
到了 8 月,DeepSeek 进一步引入硬盘缓存技术,缓存命中的输入 token 每百万仅收 0.1 元。
当时的大洋彼岸,巨头们并未全盘跟进。2024 年 7 月 OpenAI 发布 GPT-4o mini,输入输出降至 0.15 美元与 0.6 美元;但四个月后 Anthropic 推出 Claude 3.5 Haiku,标价反而是上一代的四倍。Dario Amodei 当时的逻辑是,模型更聪明了,定价必须体现智力进阶。
真正让硅谷感受到彻骨寒意的,是 2025 年 1 月。
DeepSeek-R1 横空出世,推理表现直逼 OpenAI o1,而输出每百万 token 仅需 2.19 美元,而那时 o1 的报价是 60 美元。
1 月 27 日,英伟达单日市值蒸发近 5890 亿美元,创下美股历史纪录。Marc Andreessen 将其称为 AI 领域的斯普特尼克时刻,微软 CEO Satya Nadella 在社交平台上感慨说,杰文斯悖论又灵验了。
斩杀线自此成形。
开放权重让这柄利刃更加锋利。面对闭源模型,客户只能在几份垄断价目表间做算术;而权重一旦开放,开发者既能在自己的集群上私有部署,也可以在任何一家第三方推理云上跑起同样的模型。同一个模型有了多家供应商,客户也多了自行部署的选择,模型提供方维持高溢价的空间随之缩小。
一批美国本土公司率先过了河。
2025 年 10 月,Airbnb 首席执行官 Brian Chesky 公开表示,公司的智能客服 Agent 极度依赖阿里千问,整个系统调度了 13 个模型,虽然也接入了 OpenAI 最新的旗舰,但在生产流水线里极少被调用,因为有更具性价比的替代品。
同月,Cognition 推出 SWE-1.5,宣称构建在「某个行业领先的开源基座」之上,智谱随后证实,该底座正是 GLM-4.6。
紧接着,a16z 合伙人 Martin Casado 对《经济学人》透露,带着开源模型架构来路演的美国 AI 初创企业中,大约八成用的是中国基座。
今年 3 月,代码编辑器 Cursor 发布 Composer 2,定价每百万输入 0.5 美元、输出 2.5 美元,团队最终承认基座调优自月之暗面的 Kimi K2.5。
开发者在用代码与预算投票。Mozilla 发布的报告显示,中国开放权重模型在 OpenRouter 上的 token 份额,从 2024 年底的不足 2%,升至 2026 年 4 月的超过 45%。
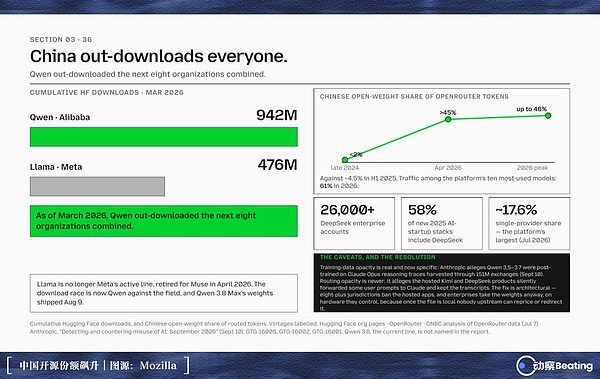
在走量与结构化调用的生态位上,高傲的闭源模型一度毫无还手之力。
代价
斩杀对手,并不必然意味着自己活得体面。
Mozilla 的同一份报告里,还有一组对照数据。2025 年 5 月至 9 月,开放模型约占 OpenRouter 平台两成的模型使用量,却只获得约 4% 的模型层收入。这是一个平台在特定时期的样本,不能代表全球市场,但使用份额与收入份额之间的落差已经十分明显。
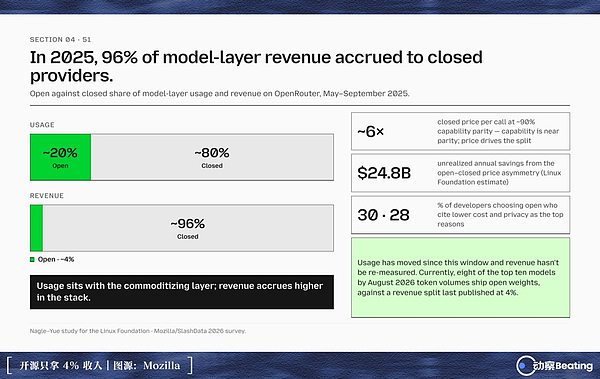
创造价值,从来不等于捕获价值。
今年 1 月,智谱与 MiniMax 相继敲钟。随后披露的中期业绩,让外界得以看清收入增长背后的成本与亏损。
智谱上半年收入 9.54 亿元,其中开放平台及 API 业务收入 8.25 亿元,占比达到 86.5%。这项业务的毛利率已经由负转正,升至 24.6%;但公司整体仍录得约 20.72 亿元净亏损,同比收窄 12.1%。卖出更多 token 开始产生毛利,但是距离覆盖公司的全部开支,还有一段距离。
MiniMax 上半年营收约 1.17 亿美元,同比增长 283.1%;净亏损约 3.58 亿美元,同比收窄 11%。剔除股份支付、金融负债公允价值变动及上市费用后,经调整净亏损约 2.93 亿美元,同比扩大 111.2%。
上市之后,低价带来的增长需要接受另一重检验。每一次调用究竟能留下多少毛利,这些毛利又能覆盖多少研发与运营开支。收入增长很快,距离公司整体盈利仍然很远。
今年春末,Agent 浪潮将算力消耗推向了临界点。
开源项目 OpenClaw 席卷全球开发者社区,至 3 月初在 OpenRouter 上的累计 token 消耗突破 8.52 万亿,雄踞榜首。3 月中旬的一周内,中国模型单周跑出了 7.36 万亿 token,环比激增 56.9%。
2 月 12 日上线的 GLM-5 一度登顶调用榜,汹涌的需求在瞬间击穿了基础设施配额。海外与国内开发者开始密集抱怨 GLM Coding Plan 出现秒级延迟和高频限流,这是中国头部 AI 团队首次公开告急求算力。
2 月 23 日,智谱单日股价暴跌近 23%,一日之内蒸发逾 700 亿港元市值。
接踵而至的,是一轮防御性涨价。
智谱在 GLM-5 推出时上调资费,3 月的 GLM-5-Turbo 价格再度上浮 20%,整体较上一代规格平均贵了 83%。
DeepSeek 在 4 月 24 日发布的 V4-Pro 拥有 1.6 万亿总参数,上线即给予 75% 峰值折扣。这把火先烧向了同行,MiniMax 两个交易日连续下挫约 9% 和 10%。
但到了 8 月中旬,DeepSeek 亦转入分时计费策略,V4-Pro 高峰期输出每百万 token 攀升至 3.96 美元,缓存命中成本上涨超 12 倍。
7 月,月之暗面发布 Kimi K3,API 标价推升至每百万输入 3 美元、输出 15 美元,比 K2.6 整整贵出三倍多。
不过,令人意外的是,涨价并未引发剧烈的客户流失。
智谱 CEO 张鹏公开透露,一季度调价 83% 后,API 调用规模反而激增了 400%。至 8 月底,智谱 MaaS 平台的年化收入摸高到 16 亿美元,API 业务毛利率奇迹般转正至 24.6%。
在算力供不应求的数月窗口期内,中国模型团队第一次触摸到了难能可贵的定价权。
然而,那条曾让海外巨头寝食难安的斩杀线,也在不知不觉间,被它们自己推高了。
闪电战
大洋彼岸在夏天完成了战略调头。
6 月底,Anthropic 发布 Sonnet 5,标出每百万输入 2 美元、输出 10 美元的首发促销价,原本明确声明 9 月将恢复至 3 美元和 15 美元。
而到了 7 月,OpenAI 推出 GPT-5.6 系列,三周后突然发动闪电战,Luna 价格降低 80%,输入端跌至 0.2 美元,输出端降至 1.2 美元。
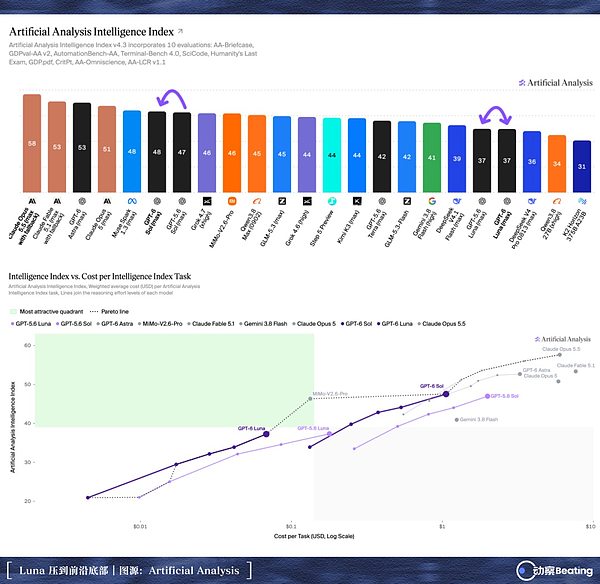
OpenAI 将这次降价归功于纯粹的底层工程重构,重写的 GPU kernel 将端到端服务成本压低了约 20%,重新训练的投机解码草稿模型令生成吞吐提速 15% 以上。
8 月 10 日,Anthropic 撤回涨价通告,宣布 Sonnet 5 永久锁定低价。
9 月 22 日,Anthropic 掏出 Opus 5.5,综合使用成本下调 40%;同日 OpenAI 推出 GPT-6 Sol 与 Luna,Luna 将入门价锁死在输入 0.1 美元、输出 0.5 美元。随后登场的,便是 Haiku 5.5。
两年前坚信「智能必须享有单独溢价」的 Anthropic,亲手撕掉了自己的标签。
现在大模型发布时的话术也变了。不再是纯粹罗列 MMLU 的微弱胜出,他们开始反复强调单位美元产出、延迟与每一步推理消耗的工程效率。
并且,在 Haiku 5.5 亮相同时,Anthropic 宣布向订阅用户全面配发 API 额度,Max 级别每月赠送 100 至 200 美元,企业 Team 用户最高可享 500 美元抵扣。
这招直切腹地。价目表上的折扣只影响单次调用决策,但一旦客户的代码工程与 Agent 编排完成适配,撬动迁移的壁垒将高如城墙。
美国巨头敢于发起这场价格战,靠的是深不可测的资金池与供应链特权。
Anthropic 的年化营运收入,从 2025 年底的约 90 亿美元,狂飙至今年 7 月底的超 650 亿美元。5 月完成的那笔高达 650 亿美元的融资,直接将其估值推上 9650 亿美元。
在算力层面,Anthropic 于 4 月宣布扩大与 Google、博通的合作,获得多吉瓦级的下一代 TPU 算力容量,预计从 2027 年起陆续上线。
与之对照,智谱年内通过配售及可转债艰难筹集 700 余亿港元,折合美元,不及 Anthropic 单轮弹药的七分之一。
出得起钱的,依然只有超级巨头。
二级市场的清算向来不留情面。
智谱于 1 月 8 日登陆港股,发行价 116.2 港元。春季的算力荒未能阻挡多头的狂热,6 月 22 日其股价冲至 2980 港元,市值一度触碰 1.33 万亿港元天花板。
随后是漫长的下跌。
7 月限售股解禁,两轮配售将定增价从 1588 港元一路砸至 714 港元。7 月 16 日 Kimi K3 登场次日,智谱全天下挫 28.48%。9 月 22 日 Opus 5.5 与 GPT-6 联袂出击,智谱跌幅再度超过 10%。
9 月 25 日,智谱盘中探底至 610.5 港元,总市值缩水至 3000 亿港元附近,自历史高点回撤近八成。
MiniMax 的轨迹同样惨烈。自 1330 港元峰值下坠,解禁当日重挫 17.98%,7 月中旬收于 216 港元。其上半年近六成收入仰赖海外客户,而海外,正是美国巨头降价风暴首当其冲的战场。
估值口径也开始收紧。据媒体转述,杰富瑞在 9 月的研报中,将智谱云业务对应的 2026 年预测年化收入估值倍数,从 50 倍下调至 30 倍,降幅为 40%。
中国模型曾经凭借极致性价比从巨头口中虎口夺食,而如今,这条路在大洋彼岸也走通了。开发者因便宜而来,自然会因更便宜而去。
0.1 美元的幽灵
2006 年 8 月 25 日,Jeff Barr 在墨西哥卡波圣卢卡斯一片燥热的海滩边,敲下了介绍 Amazon EC2 测试版的文章。
在技术说明的末尾,他写下了一个注定载入商业史的数字,开发者租用一台虚拟计算实例,每小时收费 0.1 美元。
其后的故事众人皆知。AWS 在接下来的十余年里主动下调价格逾百次,2014 年仅 S3 存储费率便腰斩 51%。
云计算从未靠着将同等算力越卖越贵来成就霸业。规模、底层自研芯片与极致运维压榨出的每一分边际利润,被源源不断地回馈给终端市场,进而吸引更多开发者。持续降价的 AWS 最终成长为年营收近 1300 亿美元、营业利润率高达 35.4% 的现金奶牛。
价格战,是规模垄断者最后的围剿战术。
今天能够把模型价格压到一折、发布即刻铺满全球三大公有云货架的人,不仅在贩卖 token,更在消化 token。Anthropic 一边血洗 API 价格,一边用庞大的推理算力反哺 Claude Code、Cowork 与自身的端到端 Agent 产品。
中国大模型团队依然没有放下武器。9 月 DeepSeek 再度下调 Flash 系列资费,小米将 MiMo-Flash 推向 1 元/百万 token 的极限,智谱亦将 GLM-5.3-Flash 定价死磕在微利区间。但牌桌上的筹码规则已经改写。
低价本身,已经不再是一张具备排他性的护城河牌。
在那张由 Artificial Analysis 实时更新的散点图上,中国公司的名字一家都没有缺席。GLM、DeepSeek、Kimi、千问、MiniMax 依然都在。
只是,它们现在已经划不出那条斩杀线了。
 |
 |
 |
 |
 |
 |
 |
 |
| 感动 | 同情 | 无聊 | 愤怒 | 搞笑 | 难过 | 高兴 | 路过 |
- 上一篇:跨平台执行交易:智能体要攻克的下一个关口
- 下一篇:没有了!
相关文章
-
没有相关内容